Der Moment, in dem eine plausible Antwort teuer wird
Ein Mitarbeiter fragt den internen Assistenten nach einer Kennzahl, einem konkreten Datensatz oder dem Ergebnis eines Berichts. Die Antwort kommt in Sekunden, ist sauber formuliert und wirkt vollständig. Nur stammt eine der genannten Zahlen aus keiner der angebundenen Quellen. Sie klingt richtig, sie passt ins Bild, und genau deshalb fällt sie niemandem auf.
In vielen Unternehmen werden Entscheidungen auf Basis abgerufener Daten, Kennzahlen und Dokumente getroffen. Ein einzelner erfundener Wert kann sich durch Auswertung, Freigabe und Dokumentation ziehen, bevor er auffällt. Retrieval-Augmented Generation (RAG) sollte dieses Risiko eindämmen, indem das Sprachmodell seine Antworten an echten Dokumenten und Datenbanken verankert statt frei aus dem trainierten Wissen zu schöpfen. Das funktioniert, und es reduziert den Spielraum für Erfindungen deutlich. Es beseitigt ihn aber nicht.
Auch ein gut gebautes RAG-System liefert Aussagen, die sich nicht aus den abgerufenen Daten ableiten lassen. Das ist keine Randerscheinung, sondern eine Eigenschaft probabilistischer Modelle, die auch in der Forschung breit dokumentiert ist (Ji et al., 2022). Die eigentliche Frage in produktiven Systemen lautet deshalb nicht, ob solche Fehler auftreten, sondern ob man sie bemerkt, bevor sie beim Nutzer ankommen. Genau diesen blinden Fleck hat eine Bachelorthesis untersucht: Wie lässt sich systematisch abfangen, was ein RAG-System trotz guter Quellen erfindet? Dieser Beitrag fasst den entwickelten Ansatz und seine Ergebnisse zusammen.
Vier Fehler, die im laufenden Betrieb immer wieder auftauchen
Wer ein RAG-System über längere Zeit im echten Einsatz beobachtet, sieht schnell, dass "Halluzination" kein einheitliches Phänomen ist. Die Forschung trennt zunächst zwei Grundformen. Eine extrinsische Halluzination liegt vor, wenn das Modell Inhalte ergänzt, die sich aus dem bereitgestellten Kontext weder bestätigen noch widerlegen lassen, also frei erzeugte Zusätze. Eine intrinsische Halluzination widerspricht dagegen direkt den Fakten, die in den abgerufenen Quellen stehen. In einem produktiven KI-Assistenten treten beide Formen auf, und daneben zeigen sich zwei weitere Fehlerbilder, die mit reiner Faktentreue gar nichts zu tun haben. Insgesamt lassen sich vier Muster klar unterscheiden.
Der erste Fall ist die unvollständige Datengrundlage und damit eine klassische extrinsische Halluzination. Ein Nutzer bittet um den Vergleich zweier Objekte, die Datenabfrage findet aber nur einen der beiden Datensätze. Statt die Lücke zu benennen, füllt das Modell die fehlenden Felder mit plausibel klingenden Werten auf. Die Antwort enthält keinen Hinweis darauf, welche Angaben belegt sind und welche das Modell selbst ergänzt hat. Es entsteht also Information, für die es im Kontext keine Grundlage gibt.
Das zweite Muster ist eine intrinsische Halluzination im Gesprächsverlauf. Werden nacheinander mehrere Objekte abgefragt, wandern Eigenschaften einer früheren Antwort in die aktuelle hinüber. Das Ergebnis widerspricht dann den Daten, die im aktuellen Abruf tatsächlich zurückkamen. Anders als beim ersten Fall wird hier nichts frei erfunden, sondern es werden korrekte Fakten aus dem falschen Zusammenhang übernommen. Der Fehler hängt nicht an der Retrieval-Qualität, sondern an der Art, wie das Modell Kontext über mehrere Schritte verarbeitet.
Das dritte Muster verlässt die Ebene der Faktentreue und betrifft die semantische Ausrichtung der Antwort. Die semantische Suche liefert Treffer mit hoher Ähnlichkeit zur Frage, die inhaltlich aber eine andere Fragestellung beantworten. Die Antwort ist im Sinne der Quellen korrekt und verfehlt dennoch das eigentliche Anliegen des Nutzers. Eine solche semantische Fehlausrichtung lässt sich durch eine reine Faktenprüfung gegen die Quellen nicht erkennen, weil formal alles stimmt und nur die Intention verfehlt wird.
Das vierte Muster ist ein Konsistenzbruch durch die Vermischung gleichartiger Datensätze aus verschiedenen Quellsystemen. Liegen zu derselben Entität ähnliche, aber unvollständige Datensätze aus zwei Systemen vor, kombiniert das Modell Felder aus beiden zu einem Datensatz, den es in keinem der Systeme in dieser Form gibt. Jeder einzelne Wert mag stimmen, in der Zusammenstellung ergibt sich aber ein Datensatz ohne reale Entsprechung, und die Herkunft der Werte ist auf Ebene der fertigen Antwort nicht mehr rekonstruierbar.
Der gemeinsame Nenner dieser Fälle ist unbequem. Sie lassen sich nicht alle durch besseres Retrieval lösen. Manche entstehen bei der Generierung, andere hängen an der Nutzerintention, wieder andere an der Nachvollziehbarkeit der Datenherkunft. Auch die Forschung zu RAG-Fehlerpunkten zeigt, dass sich Schwachstellen über die gesamte Pipeline verteilen und sich erst im laufenden Betrieb zuverlässig zeigen (Barnett et al., 2024). Eine einzelne Stellschraube reicht dafür nicht.
Eine Prüfinstanz zwischen Datenabruf und Antwort
Naheliegend ist deshalb, die Qualitätskontrolle als eigenen Schritt zu behandeln statt sie in die Antwortgenerierung hineinzuhoffen. In einem konkret umgesetzten und evaluierten Ansatz sieht das so aus: Zwischen der fertig generierten Antwort und ihrer Auslieferung an den Nutzer wird eine Validierungsschicht eingezogen. Sie erhält drei Eingaben, nämlich die ursprüngliche Nutzerfrage, die vom Modell abgerufenen Tool-Ergebnisse und die generierte Antwort. Erst wenn sie ihr Urteil abgegeben hat, geht die Antwort raus.
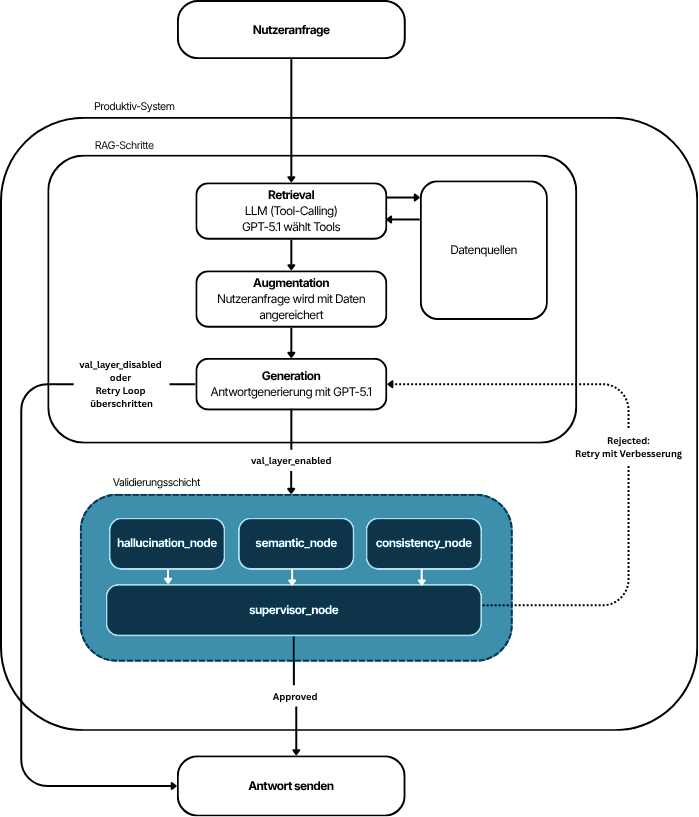
Wichtig ist, was diese Schicht bewusst nicht tut. Sie trainiert das Sprachmodell nicht nach, sie verändert weder die Prompts noch die Tool-Calling-Logik, und sie fragt die angebundenen Quellsysteme nicht erneut ab. Sie prüft die bereits erzeugte Antwort gegen die bereits abgerufenen Daten. Damit lässt sie sich in ein bestehendes System einhängen, ohne dessen Architektur umzubauen, und über einen Schalter zu- oder abschalten. Aus Sicht der umgebenden Anwendung ist sie ein zusätzlicher Verarbeitungsschritt, mehr nicht.
Technisch ist die Schicht als mehrstufiger KI-Workflow organisiert, in dem spezialisierte Prüfer nebeneinander arbeiten und ein übergeordneter Agent ihre Ergebnisse zusammenführt. Das Prinzip, Fakten nach der Generierung noch einmal gezielt zu verifizieren, ist aus der Forschung bekannt, etwa als Chain-of-Verification (Dhuliawala et al., 2023). Der hier beschriebene Ansatz überträgt diesen Gedanken auf ein produktives RAG-System mit gemischten Datenquellen.
Wie die Prüfung im Detail arbeitet
Drei Prüfer für drei Fehlerbilder
Statt einer allgemeinen Prüflogik übernimmt jede der vier Fehlerklassen ein eigener Validator mit klar abgegrenztem Auftrag.
Der Halluzination-Validator geht die Antwort Satz für Satz gegen die Quellen durch. Für jede Aussage entscheidet er, ob sie unmittelbar belegt ist, ob sie sich logisch aus den Quellen ableiten lässt oder ob sie ohne Grundlage frei erzeugt wurde. Aussagen der dritten Kategorie markiert er als halluziniert. Weil er dabei nur die im aktuellen Abruf gelieferten Daten heranzieht, erfasst er sowohl erfundene Ergänzungen bei Datenlücken als auch Inhalte, die aus früheren Gesprächsabschnitten übergelaufen sind.
Der Semantik-Validator beurteilt, ob die Antwort das inhaltliche Anliegen der Frage trifft. Er arbeitet bewusst auf der Bedeutungsebene und interessiert sich nicht für Formulierung oder Reihenfolge, sondern dafür, ob alle Aspekte der Frage beantwortet werden und ob die Antwort am Thema bleibt. So fällt auch die Themenabweichung auf, die eine reine Faktenprüfung durchwinken würde.
Der Konsistenz-Validator schaut auf die fertige Antwort sowie auf die abgerufenen Rohdaten. Er sucht nach denselben Entitäten, die in mehreren Quellsystemen mit abweichenden Attributen auftauchen, und klärt, ob deren Datensätze getrennt kenntlich bleiben oder bereits unzulässig zu einem einzigen zusammengezogen wurden.
Die drei Prüfer laufen unabhängig voneinander und parallel. Jeder arbeitet in einem eigenen, isolierten Kontext und übernimmt ausdrücklich keine Begründungen aus dem Modell, das die Antwort erzeugt hat. Damit lässt sich vermeiden, dass ein Prüfer die Fehlannahmen des Generators einfach übernimmt. Sein Ergebnis legt jeder Validator strukturiert ab, mit einer numerischen Bewertung zwischen null und eins, den konkret gefundenen Problemen und einer kurzen Begründung.
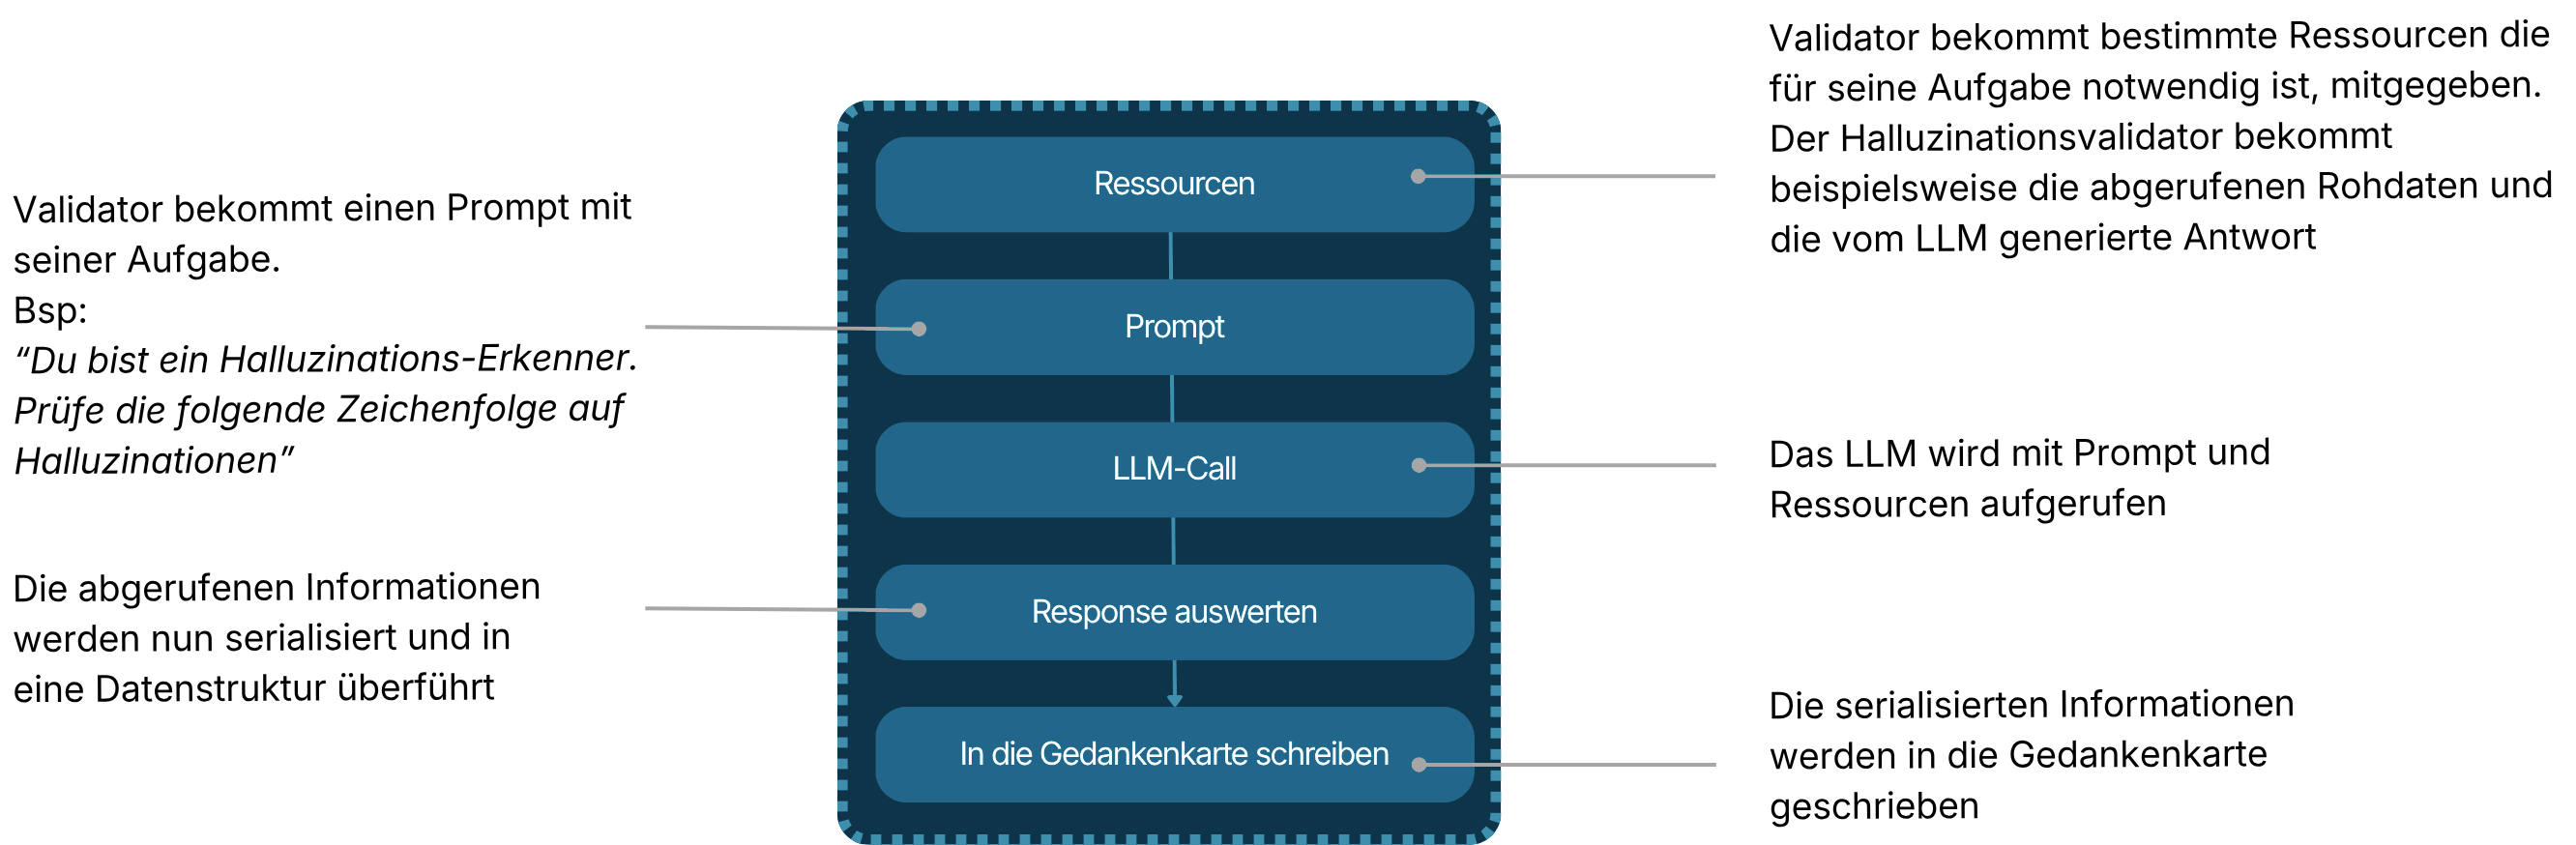
Intern arbeiten alle drei Validatoren nach demselben Schema. Jeder bekommt genau die Ressourcen mitgegeben, die er für seinen Auftrag braucht, dazu einen Prompt, der seine Rolle festlegt. Auf dieser Grundlage erfolgt ein einzelner Modellaufruf, dessen Antwort ausgewertet, serialisiert und als strukturierter Eintrag abgelegt wird.
Der Supervisor entscheidet, was ausgeliefert wird
Die Ergebnisse der drei Prüfer landen in einer gemeinsamen Datenstruktur, hier als Gedankenkarte bezeichnet. Weil die Validatoren parallel schreiben, werden ihre Einträge über einen Reducer zu einer einzigen Liste zusammengeführt. Der Supervisor wird erst aktiv, wenn alle drei Befunde vorliegen, und liest ausschließlich diese Gedankenkarte aus.
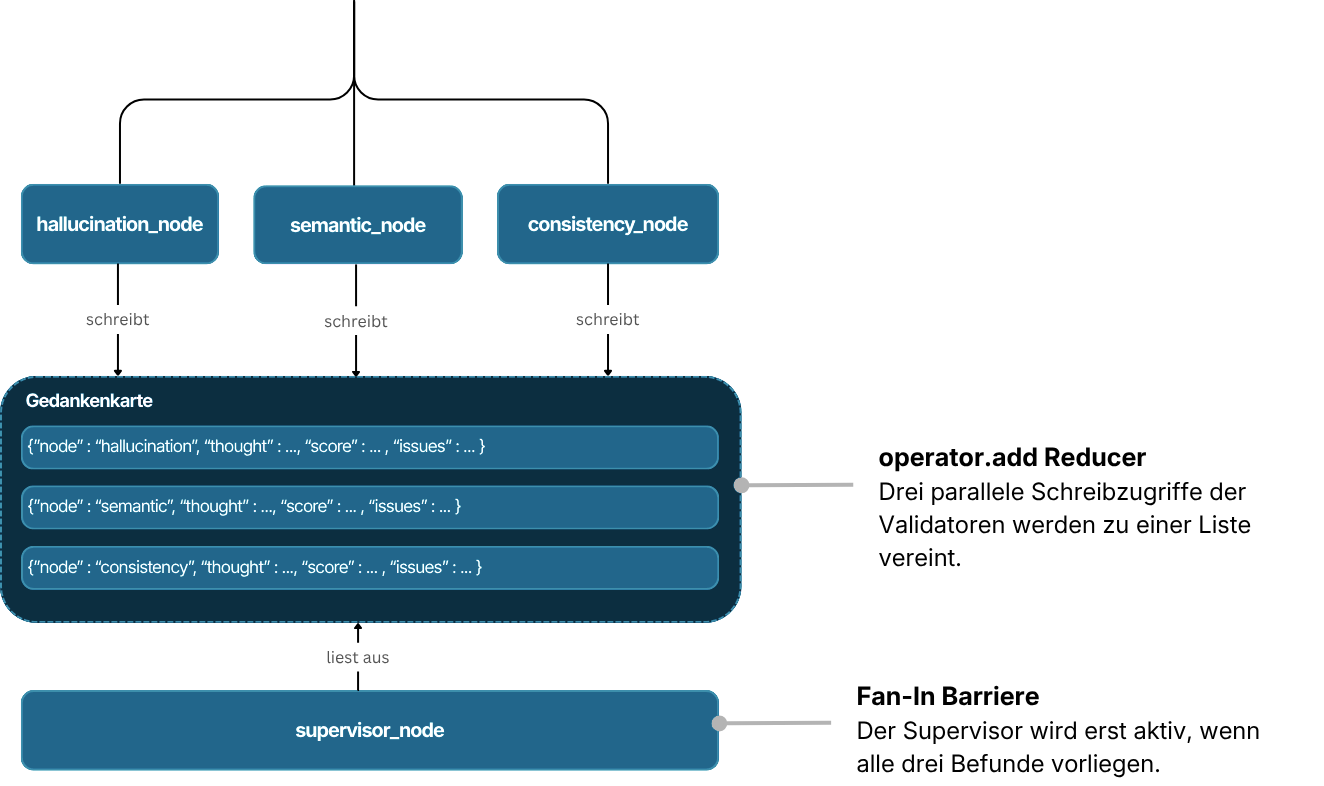
Über den drei Prüfern steht damit der Supervisor. Er prüft die Antwort nicht noch einmal selbst, sondern konsolidiert die vorliegenden Bewertungen und trifft daraus eine nachvollziehbare Entscheidung. Fällt die Bewertung eines Validators unter einen Schwellenwert von 0,6 oder meldet der Halluzination-Validator eine unbelegte Aussage, wird die Antwort zurückgeführt. Andernfalls wird sie unverändert ausgeliefert.
Die unbelegte Aussage hat dabei eine Sonderstellung. Sie löst die Rückführung unabhängig von der numerischen Bewertung aus. Das folgt der Logik des Anwendungsfalls, denn eine faktisch unbelegte Angabe wiegt schwerer als eine semantische Unschärfe, weil sie unbemerkt zur Entscheidungsgrundlage werden kann. Der Schwellenwert von 0,6 wurde heuristisch gesetzt und liegt bewusst über einem einfachen Mehrheitskriterium, damit knappe Grenzfälle nicht schon als sauber durchgehen.
Wird eine Antwort abgelehnt, formuliert der Supervisor aus den Prüfergebnissen einen konkreten Verbesserungshinweis, mit dem das Sprachmodell eine korrigierte Antwort erzeugt. Die bereits abgerufenen Daten bleiben dabei unverändert, sodass die Quellsysteme nicht erneut belastet werden. Dieser Korrekturlauf ist auf einen einzigen Wiederholungsversuch begrenzt. Diese Obergrenze hält den Ablauf berechenbar und verhindert, dass eine Anfrage in einer endlosen Schleife zwischen Generierung und Prüfung hängen bleibt.
Von der Vermutung zur Messung
Der interessante Teil beginnt bei der Frage, ob so eine Prüfschicht tatsächlich hält, was sie verspricht. Getestet wurde sie gegen ein eigens erstelltes Golden Set aus 80 Anfragen, davon 60 fehlerhafte und 20 saubere. Jeder Eintrag enthält Frage, zu prüfende Antwort, zugrunde liegende Tool-Ergebnisse und ein manuell vergebenes Soll-Label. Die Prüfung wird als binäre Klassifikation ausgewertet, bei der die fehlerhafte Antwort die zu erkennende Klasse ist.
Eine Entscheidung ist dabei bewusst gefallen. Bewertet wird nicht mit einem weiteren Sprachmodell als Richter. Der Grund ist naheliegend, wenn man ihn einmal ausspricht: Wenn das Messinstrument dieselbe Art von Modell ist, die auch die Fehler produziert, lassen sich systematische Fehleinschätzungen des Bewerters nicht mehr sauber von echten Erkennungslücken der Prüfschicht trennen. Stattdessen wird gegen die kuratierte Referenz mit Precision, Recall und F1-Score gemessen.
Mit GPT-5.1 erreichte die Schicht die beste Erkennungsgüte im Vergleichsfeld. Sie erkannte 57 der 60 fehlerhaften Antworten und wies dabei eine perfekte Precision auf, lehnte also keine einzige korrekte Antwort fälschlich ab. Das ist der praktisch wichtige Punkt: Der Qualitätsgewinn wird nicht mit einer Flut unnötiger Rückweisungen erkauft. In der Auswertung nach Fehlerklasse wurden Halluzinationen und Konsistenzbrüche vollständig erkannt. Die drei nicht erkannten Fälle entfielen sämtlich auf semantische Themenabweichungen, von denen 17 der 20 Fälle erwischt wurden. Genau dort, wo formal alles stimmt und nur die Intention verfehlt wird, bleibt die Prüfung erwartungsgemäß am schwierigsten.
Ergebnisse mit GPT-5.1.
Ebenso ehrlich gehört dazu, was die Auswertung noch offenlässt. Gemessen wurde die Erkennung fehlerhafter Antworten, nicht die Güte der anschließenden Korrektur. Dass eine als fehlerhaft markierte Antwort im zweiten Anlauf tatsächlich besser wird, ist eine eigene Frage und ein sinnvoller nächster Schritt. Auch der Schwellenwert ist heuristisch. Für weiterführende Arbeiten sind das die Stellen, an denen man fortführen würde.
Was das für produktive KI-Assistenten bedeutet
Der eigentliche Gewinn liegt weniger in der einzelnen erkannten Halluzination als in dem, was eine solche Schicht mit der Betriebsführung macht. Jede Prüfentscheidung ist protokolliert, samt der Frage, welcher Prüfer aus welchem Grund abgelehnt oder bestätigt hat. Aus einem "vertrau der KI" wird ein "wir sehen, wann sie danebenliegt", und das ist genau die Grundlage, die für Governance, Verantwortlichkeiten und Freigaben in einem Unternehmen gebraucht wird.
Damit verschiebt sich auch die Frage, mit der KI-Assistenten in den Regelbetrieb gehen. Solange ein System im Pilotbetrieb läuft, reicht oft der Eindruck, dass die Antworten gut aussehen. Sobald Fachanwender täglich auf dieser Grundlage arbeiten, zählt nicht mehr nur, ob das System antworten kann, sondern ob man erkennen kann, wenn es falsch liegt. Der Weg vom überzeugenden Prototyp zum produktionsreifen System führt fast immer über diese Art von messbarer Kontrolle, und AMAI arbeitet seit 2018 genau an dieser Brücke, unter europäischen Datenschutz- und Qualitätsstandards. Wer sich mit dem Thema strukturierter KI-Workflows weiter befassen möchte, findet in den Insights von AMAI verwandte Überlegungen dazu, wie sich solche Bausteine sauber in bestehende Systeme einfügen.
Wie stellen Sie heute sicher, dass Ihre KI-Assistenten keine falschen Fakten ausliefern, bevor eine Entscheidung darauf aufbaut? Wenn Sie vor ähnlichen Fragen stehen, lassen Sie uns gerne dazu austauschen.